Як ми створюємо штучний інтелект за допомогою алгоритмів оптимізації?
Стаття пояснює, як алгоритми оптимізації навчають нейронні мережі: оцінюють результат, обчислюють градієнти й поступово коригують параметри моделі.
Коротко:
- Штучний інтелект працює завдяки нейронним мережам, які обробляють дані за допомогою мільярдів параметрів.
- Алгоритми оптимізації оцінюють роботу моделі та поступово змінюють її параметри, щоб покращити результат.
- Перевірка на нових даних допомагає з’ясувати, чи справді модель навчилася розпізнавати закономірності, а не просто запам’ятала приклади.
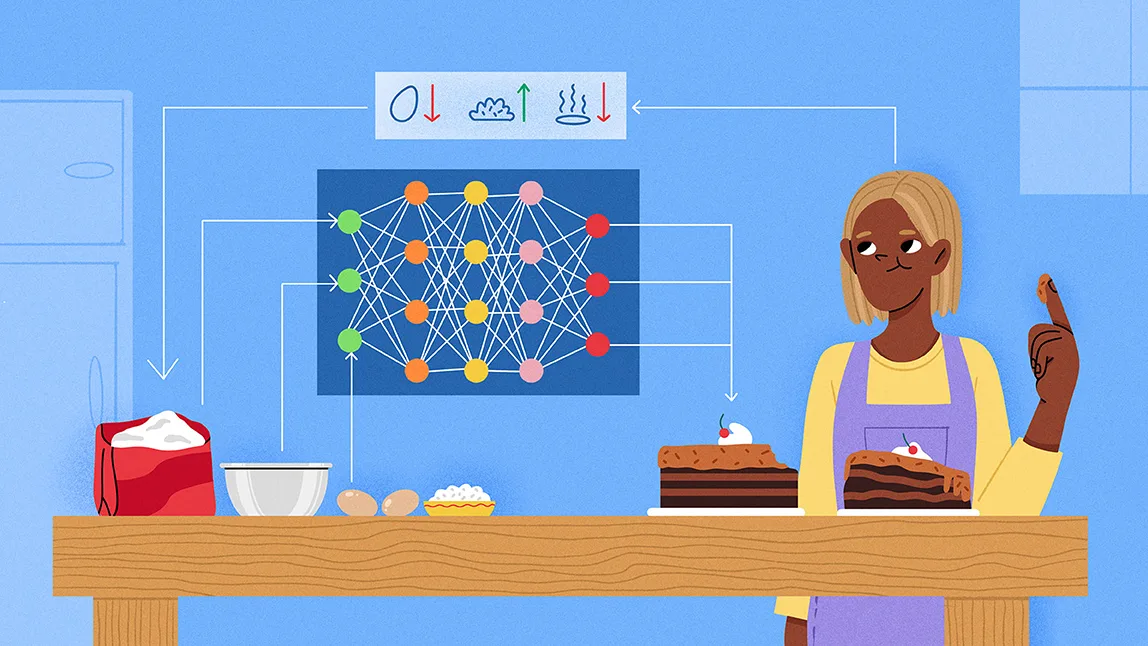
Уявіть, що ви готуєте улюблений торт за рецептом. Іноді він виходить ідеальним, а іноді потрібно змінити кількість цукру або час випікання, щоб покращити результат. Але що робити, якщо потрібно створити абсолютно новий рецепт із нуля? Створення штучного інтелекту (ШІ) схоже на це, проте потребує набагато складнішого рецепта! Щоб «приготувати» розумний ШІ, науковці поєднують мільярди інструкцій саме в потрібний спосіб, щоб програма могла розпізнавати закономірності, розв’язувати задачі й міркувати подібно до людини. Однак майже неможливо заздалегідь вгадати найкращу послідовність інструкцій. Алгоритми оптимізації працюють як помічники-кухарі: перевіряють, наскільки добре функціонує ШІ, з’ясовують, що не так, і коригують рецепт, щоб його покращити. Вони допомагають фахівцям з інформатики знаходити дедалі кращі версії рецепта, поки ШІ не стане розумнішим і потужнішим — так само, як під час удосконалення смачного торта!
Як «приготувати» інтелект
Ми всі любимо їсти. Але більшість із нас не просто виживає, споживаючи те, що можна знайти в природі, прямо з куща (або кістки). Натомість ми розділяємо зібрану їжу на різні частини, готуємо, поєднуємо й обробляємо їх, щоб отримати смачну та поживну страву. Багато страв, які люди люблять їсти, — салат, торт, курячий суп або недільне смажене м’ясо — складаються з багатьох інгредієнтів і етапів приготування, виконаних у певний спосіб. Із часом люди навчилися створювати рецепти — найкращі способи підготувати й поєднати інгредієнти, щоб отримати смачну та поживну їжу.
Штучний інтелект (ШІ) працює майже так само: спочатку збирають певні дані, а потім розділяють їх на маленькі частини. ШІ обробляє та повторно поєднує ці частини, аж поки не видає потрібний результат: повідомляє, що зображено на фотографії, виправляє твір або навіть змушує роботизовану руку зірвати квітку. Отже, вітаємо! Ви отримали квиток на спеціальну екскурсію таємничою фабрикою ШІ Віллі Вонки. У цій статті ми зазирнемо всередину секретної «кухні», де створюють ШІ.
Що саме таке ШІ? Це різновид комп’ютерної програми, яка працює з даними. Інакше кажучи, така програма отримує певні вхідні дані — наприклад, текст, зображення, відео в реальному часі або послідовність ДНК — і перетворює їх на вихідні дані: відповідь на текст, опис зображення, кількість людей у відео або прогноз щодо типу білка, який кодується ДНК. Таку програму часто називають моделлю, адже саме це вона й робить: моделює зв’язок між тим, що надходить на вході, і тим, що має з’явитися на виході. Моделі, з яких складається більшість того, що ми сьогодні називаємо ШІ, є особливим видом моделей — штучними нейронними мережами, або просто нейронними мережами (рисунок 1).
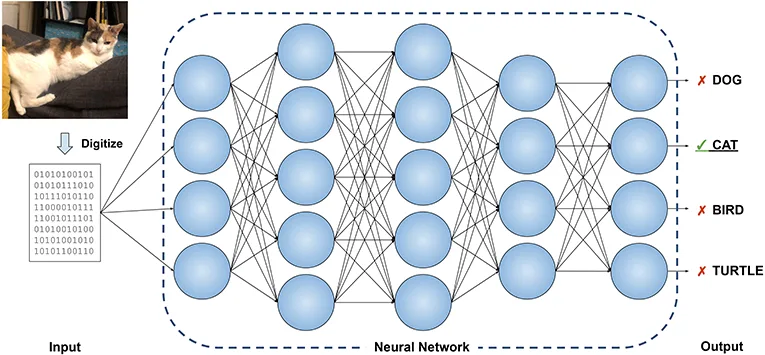
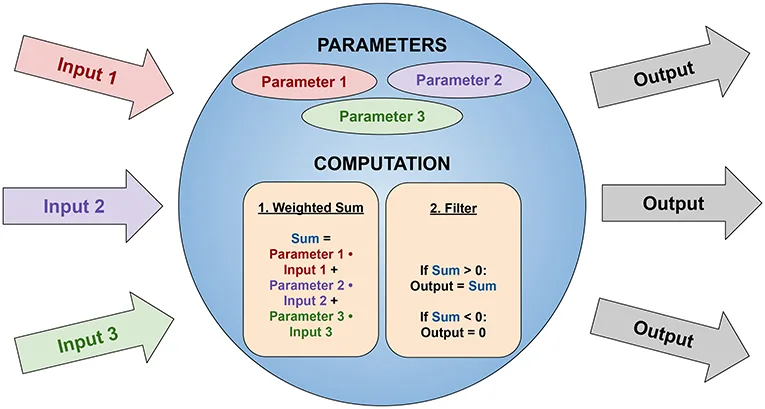
Щоб ШІ працював, спочатку вхідні дані оцифровують, тобто перетворюють на набір чисел, які програма добре розуміє. Наприклад, це можуть бути значення кольорів усіх пікселів на зображенні або у відео. Потім ці оцифровані дані проходять через нейронну мережу. Більшість нейронних мереж складається з шарів, які, своєю чергою, утворені нейронами — обчислювальними одиницями. Нейрони отримують вхідні дані, множать їх на спеціальні числа, які називаються параметрами й відрізняються для кожного нейрона, а потім додають отримані результати. Якщо сума більша за 0, нейрон передає її наступному шару нейронів і так далі, доки ми не отримуємо остаточну відповідь. Важливо, що кожен нейрон має власні параметри, тобто виконує власну роботу в мережі. Наприклад, у нейронній мережі, навченої розпізнавати зображення, один нейрон може шукати форми, схожі на очі, а інший — автомобільні колеса (рисунок 2).
Терплячий кухар усередині ШІ
Але звідки беруться параметри кожного нейрона? Вибір значень параметрів для кожного нейрона трохи нагадує створення оптимального рецепта для потрібної страви. Навіть для простого рецепта — наприклад, ідеального поєднання води, лимонного соку та цукру для лимонаду — може знадобитися кілька спроб, щоб знайти правильні комбінації. Як можна здогадатися, що більше у вас інгредієнтів і комбінацій, то складніше правильно все збалансувати.
А тепер уявіть, що ви намагаєтеся спекти торт із тисячею різних шарів, глазурі та начинок. Усі вони мають бути ідеальними за смаком і текстурою, щоб кожен шматочок був чудовим, а торт не обвалився під власною вагою! Саме такими є сучасні моделі ШІ. Ці моделі, здатні розпізнавати обличчя, писати історії або керувати автомобілями, мають мільярди параметрів, які складним чином впливають один на одного. Оскільки нейрони в мережах передають сигнали один одному, зміна одного параметра може непомітно змінити вплив сотень інших. Просто неможливо заздалегідь вгадати ідеальні значення параметрів [1].
Саме тут і з’являються алгоритми оптимізації — наші невтомні та терплячі кухарі. Вони вміють куштувати кожну версію рецепта, приблизно оцінювати, наскільки вона далека від ідеалу, і розумним, систематичним способом змінювати рецепт, щоб наступна спроба була трохи кращою за попередню.
Скуштувавши результат за поточним рецептом, зазвичай можна зрозуміти, якщо сталося щось просте: наприклад, страва надто солона, солодка або перепечена. Ці проблеми можна безпосередньо пов’язати з тим, що ви робили під час приготування. Але не кожну помилку так легко помітити. Іноді остаточний смак просто не такий, як треба, і ви не знаєте, на якому з численних етапів сталася помилка — або, можливо, їх було кілька. Ситуація ще складніша, тому що інгредієнти можуть зазнавати багатьох перетворень. Наприклад, смак шоколаду змінюється залежно від температури та перемішування, і важко точно визначити, який саме етап спричинив зміну остаточного смаку. У ШІ це складна частина: зміна інструкцій на ранніх етапах рецепта може вплинути на кінцевий результат так, що ми не зможемо легко це передбачити. Саме тому ми покладаємося на алгоритми оптимізації. Після кожної «спроби випікання» алгоритми оцінюють, наскільки добре працює ШІ, а потім обережно коригують кожен крок інструкцій, щоб покращити результат.
Але як алгоритми оптимізації знають, як змінювати параметри? Тут на допомогу приходить математика. У технічних термінах алгоритми оптимізації виконують ці коригування, використовуючи так звану градієнтну інформацію [2, 3]. Якщо коротко, градієнт — це математична відповідь на запитання: «Якби можна було трохи змінити кожен параметр, щоб результат став кращим, наскільки потрібно змінити кожен із них?» Градієнтна інформація повідомляє алгоритму оптимізації, як коригувати параметри. У багатьох випадках завдяки повторному обчисленню градієнта та внесенню змін результат поступово покращується, поки модель не наблизиться до одного з найкращих можливих результатів. Це схоже на підйом на пагорб: ви крок за кроком рухаєтеся до вершини. У кулінарній аналогії градієнт — це докладний список нотаток про смак, який підказує, як зробити торт лише трохи кращим: додати ще трохи цукру до глазурі, покласти трохи менше борошна в корж і трохи зменшити температуру духовки. Для нейронних мереж це перетворюється на такі вказівки: «зроби цей параметр трохи більшим, а той — трохи меншим». Якщо градієнт великий, це схоже на очевидну помилку, яку можна одразу відчути на смак. Натомість малі градієнти нагадують тонкі відмінності смаку, які помітить лише уважний кухар (рисунок 3).
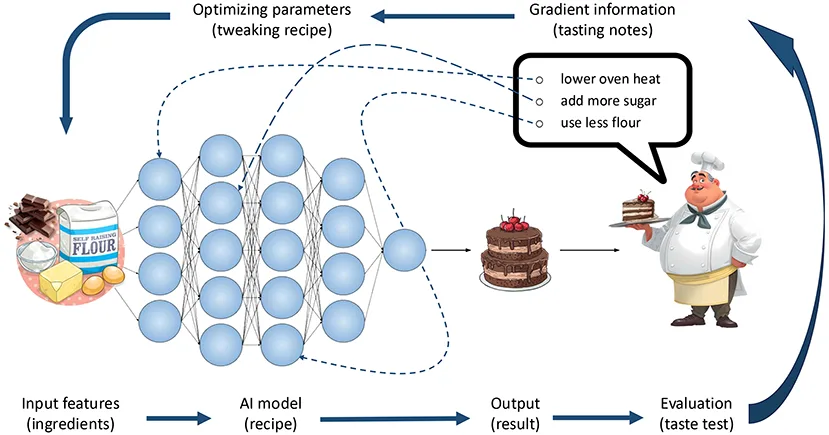
Загалом процес навчання нейронної мережі складається з послідовності кроків, які багато разів повторюються, щоб поступово вдосконалювати модель:
- Передати ознаки вхідних даних через модель ШІ, щоб отримати вихідний результат.
- Оцінити вихідний результат і визначити, наскільки він відрізняється від бажаного.
- Обчислити градієнтну інформацію на основі цієї оцінки.
- Скоригувати параметри кожного нейрона, щоб покращити модель.
- Повторити кроки 1–4 з оновленими параметрами.
Завдяки алгоритмам оптимізації ми можемо й далі вдосконалювати наші «рецепти» ШІ, поки вони не стануть розумнішими, точнішими та потужнішими — так само, як завдяки терпінню й практиці можна довести до досконалості смачний торт.
Чи готовий рецепт для гостей?
Тепер, коли ви розумієте, як оптимізувати параметри моделі ШІ, природно виникає запитання: коли припинити вдосконалення й нарешті використати результат? На практиці є два поширені та обґрунтовані критерії зупинки. Перший — коли модель досягає рівня роботи, достатнього для наших потреб. Другий — коли подальша оптимізація більше не дає помітного покращення. Обидві ідеї відповідають кулінарній аналогії. Коли ви задоволені смаком торта, можна просто припинити змінювати рецепт і використати наявну версію. Або, якщо у вас є терпіння та ресурси, можна продовжувати експерименти доти, доки спроби й надалі помітно покращують смак.
Нарешті, щоб по-справжньому оцінити модель ШІ, науковці проводять окремий етап перевірки, під час якого тестують модель на ознаках вхідних даних, які не використовувалися під час навчання. Це показує, чи навчилася модель розпізнавати закономірності, що працюють на нових прикладах, чи просто стала дуже добре працювати з прикладами, на яких практикувалася. Другий випадок називається перенавчанням: модель добре працює на навчальних даних, але погано — на нових. У кулінарному світі це схоже на запрошення друзів скуштувати торт після того, як ви залишилися задоволені оптимізованим рецептом. Оскільки вони не брали участі у ваших спробах і помилках, їхня реакція показує, наскільки добре рецепт працює для інших.
Підсумовуючи, навчання моделі ШІ схоже на розроблення рецепта за допомогою повторних експериментів: кожна помилка дає інформацію, яку можна використати для покращення результату. Алгоритми оптимізації спрямовують ці вдосконалення, а перевірка допомагає з’ясувати, чи працює модель на нових прикладах, а не лише на тих, з якими вона зустрілася під час навчання. Розуміння цього процесу важливе, адже показує: ШІ навчається не завдяки магії — його здібності залежать від ретельного навчання, тестування та рішень людей.